22 de setembro de 2026
Grok 4.7 vs Claude Opus 5.5 vs GPT-6 Sol e Luna: Guia Prático de Escolha e Benchmarks
Em setembro de 2026, xAI, Anthropic e OpenAI lançaram Grok 4.7, Claude Opus 5.5 e a dupla GPT-6 Sol e Luna. Analisamos dados reais de benchmarks, custos de API e a matriz de decisão prática para saber onde aplicar cada modelo.
por Vinicius Levi
Resposta rápida
Em setembro de 2026, xAI, Anthropic e OpenAI atualizaram o ecossistema de inteligência artificial. O Claude Opus 5.5 lidera programação autônoma profunda e raciocínio com 66,4% no Terminal-Bench 4.0 e redução de 40% no custo operacional. O GPT-6 Sol posiciona-se como o cavalo de batalha diário intermediário ($2/$10 por milhão de tokens), enquanto o GPT-6 Luna assume tarefas de alto volume por apenas $0,10/$0,50. O Grok 4.7 entrega ganhos substanciais em engenharia técnica e tarefas de terminal com auto-verificação contínua.
Em setembro de 2026, xAI, Anthropic e OpenAI redefiniram os modelos de fronteira com especializações bem demarcadas: Claude Opus 5.5 para raciocínio profundo e agentes de código, GPT-6 Sol como workhorse equilibrado, GPT-6 Luna para tarefas operacionais de alto volume e Grok 4.7 para engenharia técnica em terminal.
A disputa de modelos em setembro de 2026: além dos benchmarks sintéticos
Em uma janela de apenas 48 horas, o ecossistema global de inteligência artificial recebeu uma sequência sem precedentes de anúncios. xAI, Anthropic e OpenAI apresentaram suas novas apostas para o topo da esteira produtiva: Grok 4.7, Claude Opus 5.5 e a dupla GPT-6 Sol e Luna.
Mais do que disputar dígitos marginais em provas acadêmicas sintéticas, os lançamentos desta rodada revelam uma mudança clara de maturidade: as empresas agora desenham modelos para cargas de trabalho de agentes autônomos, execução repetitiva de testes em terminal, refatoração de bases de código completas e controle rigoroso de custo computacional por milhão de tokens.
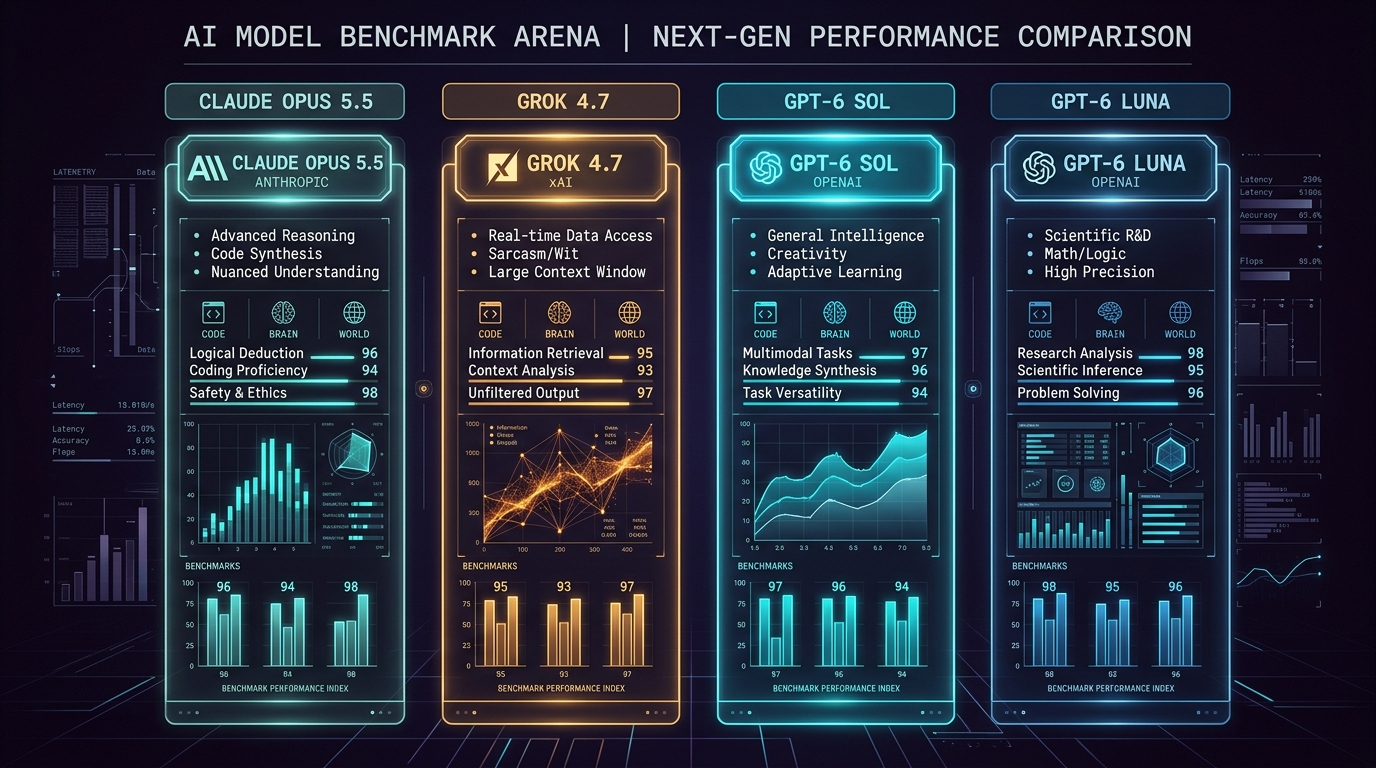
Para desenvolvedores, CTOs e operadores de automações comerciais, essa fragmentação exige uma decisão de arquitetura: escolher o modelo certo para cada estágio do pipeline define se a operação terá margem de lucro ou se consumirá créditos de API de forma predatória.
Especificações técnicas, custos de API e contexto
A tabela abaixo sintetiza os dados oficiais divulgados pelas três fabricantes, comparando a precificação por milhão de tokens e o tamanho das janelas de contexto:
| Modelo | Provedor | Janela de Contexto | Entrada (Input / 1M) | Saída (Output / 1M) | Leitura de Cache (1M) |
|---|---|---|---|---|---|
| Claude Opus 5.5 | Anthropic | 1.000.000 | $4,00 | $20,00 | $0,20 |
| GPT-6 Sol | OpenAI | 1.050.000 | $2,00 | $10,00 | $0,20 |
| GPT-6 Luna | OpenAI | 1.050.000 | $0,10 | $0,50 | $0,01 |
| Grok 4.7 | xAI | 500.000 | $2,00 | $6,00 | N/D |
(Dados consolidados a partir dos anúncios de lançamento de 21 e 22 de setembro de 2026).
Dois números mudam a equação econômica de times que mantêm agentes rodando 24 horas por dia:
- O corte de 60% no cache do Claude Opus 5.5: modelos anteriores da família Opus tornavam o envio recorrente de prompts de sistema proibitivo. Ao reduzir a leitura de cache para $0,20 por milhão de tokens, o custo total de pipelines de desenvolvimento complexos caiu cerca de 40%.
- O piso operacional do GPT-6 Luna: com $0,10 na entrada e $0,50 na saída, o Luna substitui modelos legados leves mantendo a mesma janela massiva de 1,05 milhão de tokens, permitindo ler contratos e bases documentais inteiras com custo negligenciável.
[!tip] Eficiência de Infraestrutura
Para projetos com múltiplos microsserviços, agentes de IA e automações que exigem VPS robusto com baixa latência e integração via MCP, utilize a hospedagem Hostinger com o cupom oficial THALENA para obter 10% de desconto adicional na infraestrutura.
Desempenho real: Terminal, IDE e Engenharia Aplicada
A tabela a seguir compara o comportamento dos novos modelos em benchmarks aplicados à engenharia de software e raciocínio de terminal:
| Benchmark / Capacidade | Claude Opus 5.5 | Grok 4.7 | GPT-6 Sol | Destaque Técnico |
|---|---|---|---|---|
| Terminal-Bench 4.0 (Loops em terminal) | 66,4% | 37,6% | 57,9% | Claude Opus 5.5 estabelece nova liderança |
| CursorBench 4.0 (Edição e contexto em IDE) | 57,8% | 46,3% | 52,1% | Claude lidera precisão de contexto |
| DeepSWE v1.1 (Engenharia de software) | 73,2% | 71,0% | 68,5% | Grok 4.7 empata tecnicamente com líderes |
| EEBench (Engenharia Elétrica / Hardware) | 59,1% | 64,0% | 56,2% | Grok 4.7 lidera domínio técnico de hardware |
O Claude Opus 5.5 alcançou o primeiro lugar absoluto no Terminal-Bench 4.0 com 66,4%. Isso se traduz diretamente em menos falhas quando um agente autônomo executa scripts em zsh/bash, gerencia containers e tenta se auto-corrigir em falhas de compilação.
Por outro lado, o Grok 4.7 apresentou uma curva de evolução nítida em engenharia de sistemas e hardware (64,0% no EEBench), resultado direto de sessões prolongadas de treinamento por reforço direcionadas a raciocínio com auto-verificação.
Matriz de decisão prática: qual modelo escolher
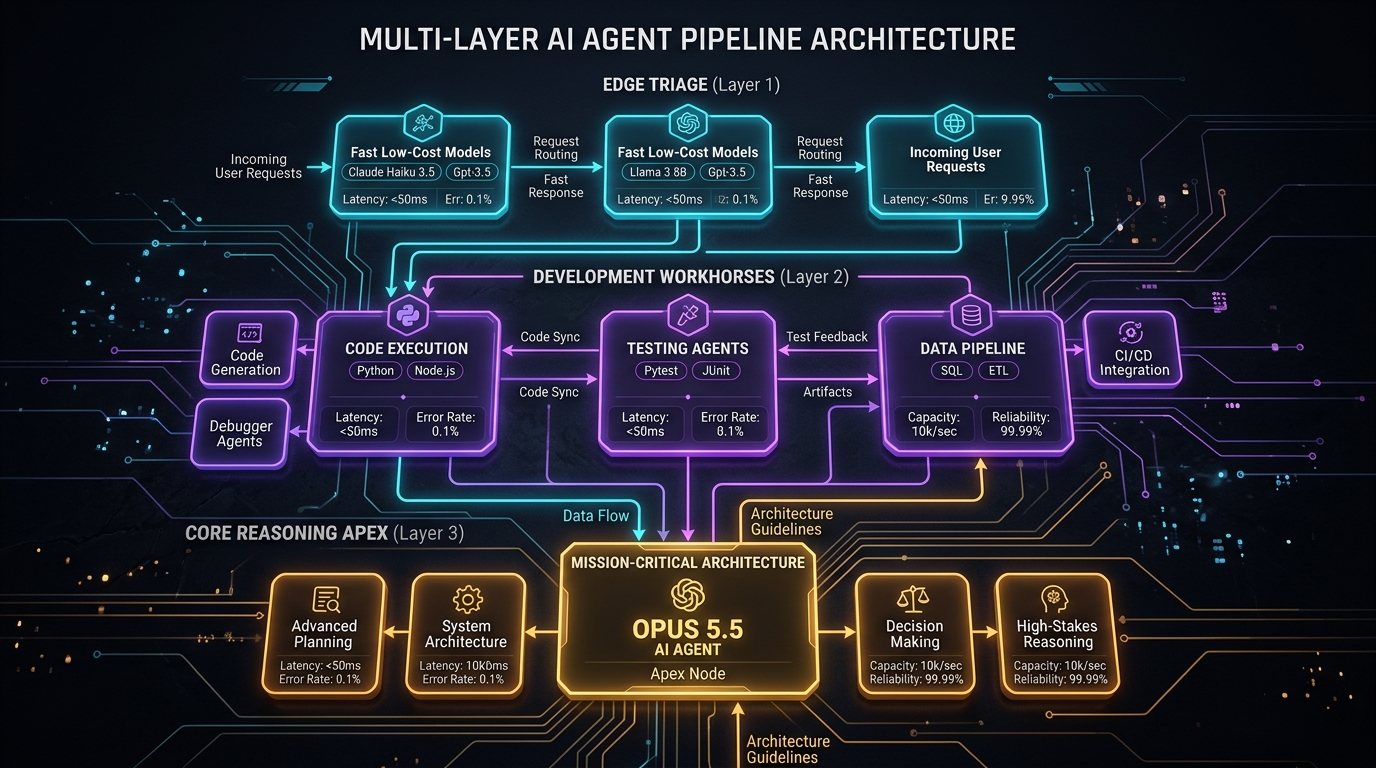
Ao invés de adotar uma abordagem monolítica, as empresas com melhor retorno sobre investimento em IA dividem suas tarefas em três camadas de atuação:
1. Camada de Borda e Triagem: GPT-6 Luna
Reserve o GPT-6 Luna para a primeira linha de contato: classificação de intenção no WhatsApp, categorização de e-mails, extração inicial de entidades e sanitização de dados. Cobrando apenas uma fração de centavo por requisição, ele impede que consultas banais consumam tokens de modelos caros.
2. Camada de Execução Diária: GPT-6 Sol e Grok 4.7
O GPT-6 Sol funciona como o desenvolvedor pleno da equipe: cria endpoints, escreve testes unitários, formata dados e documenta fluxos de forma rápida e estável. Para engenheiros que operam diretamente no Cursor ou no GitHub Copilot com foco em hardware e backend, o Grok 4.7 é uma alternativa agressiva com saída a $6,00 por milhão.
3. Camada de Raciocínio Crítico e Agentes: Claude Opus 5.5
Quando a tarefa exige ler múltiplos arquivos de arquitetura, planejar migrações completas de banco, orquestrar múltiplos subagentes e tomar decisões irreversíveis em produção, o Claude Opus 5.5 é indispensável. O investimento maior por token de saída ($20,00) é compensado pelo menor número de tentativas necessárias para resolver o problema de ponta a ponta.
Recursos, Descontos e Ecossistema Lena AI
Para acelerar o desenvolvimento de soluções com agentes de IA e integrar esses modelos na sua rotina:
- 🎁 Materiais Gratuitos e Templates: Acesse a comunidade e recursos abertos na Lena Academy.
- ⚡ Infraestrutura em Nuvem: Contrate servidores para agentes na Hostinger com o cupom THALENA (10% de desconto).
- 🎓 Formação Especializada: Desenvolva agentes práticos no Treinamento IA Experts.
- 🏢 Implementação para Empresas: Estruture agentes comerciais e automação com a equipe em Lena AI Soluções.
- 📲 Bastidores e Testes Diários: Acompanhe análises e demonstrações práticas com Vinicius Levi no Instagram: @vinilevy.
Respostas citáveis
Qual IA escolher entre Grok 4.7, Claude Opus 5.5, GPT-6 Sol e GPT-6 Luna?
Para desenvolvimento autônomo, agentes de código em larga escala e arquitetura de sistemas complexos, o Claude Opus 5.5 é a recomendação técnica primária (66,4% no Terminal-Bench 4.0). Para fluxos diários de desenvolvimento, depuração contínua e equilíbrio financeiro, utilize GPT-6 Sol ou Grok 4.7. Já para operações de alto volume, triagens, classificação e pipelines de suporte, o GPT-6 Luna entrega custo imbatível ($0,10/$0,50).
Quais são os preços de API do Grok 4.7, Claude Opus 5.5 e GPT-6 Sol e Luna?
O Claude Opus 5.5 custa $4,00 de entrada e $20,00 de saída por milhão de tokens (cache a $0,20). O GPT-6 Sol cobra $2,00 na entrada e $10,00 na saída (cache a $0,20). O Grok 4.7 é tarifado a $2,00 na entrada e $6,00 na saída. O GPT-6 Luna opera a $0,10 de entrada e $0,50 de saída por milhão de tokens.
Blocos citáveis
- O Claude Opus 5.5 lidera o benchmark Terminal-Bench 4.0 com 66,4% de acurácia, superando gerações anteriores com 40% menos consumo de tokens e custo de cache reduzido para $0,20 por milhão.
- O GPT-6 Sol foi concebido pela OpenAI como o modelo intermediário de produtividade diária, com contexto de 1,05 milhão de tokens e preço de $2 por milhão de entrada e $10 por milhão de saída.
- O GPT-6 Luna redefine o piso de custos para modelos de fronteira leve ao tarifar $0,10 por milhão de tokens de entrada e $0,50 por saída, com contexto estendido de 1,05M de tokens.
- O Grok 4.7 traz treinamento estendido de reinforcement learning para tarefas de longa duração e auto-verificação, registrando 71,0% no DeepSWE v1.1 e 64,0% no EEBench.
Perguntas frequentes
Fontes e evidências
O Claude Opus 5.5 alcançou 66,4% no Terminal-Bench 4.0 e 57,8% no CursorBench 4.0 com redução de 40% no custo total de execução em comparação ao Opus 5.
OpenAI disponibilizou GPT-6 Sol ($2,00 input / $10,00 output) e GPT-6 Luna ($0,10 input / $0,50 output) com janela de 1,05 milhão de tokens e 128k de saída máxima.
xAI lançou o Grok 4.7 com contexto de 500k tokens, pontuando 71,0% no DeepSWE v1.1 e 64,0% no EEBench a $2,00 input / $6,00 output por milhão de tokens.
Próximas leituras
IA na prática
CRM de WhatsApp Grátis com Agente de IA: Guia Completo de Instalação
Por Thalena Lima · 9 min
IA na prática
IA pra empresas: guia prático para melhorar processos internos
Por Vinicius Levi · 5 min
Conceitos sobre IA
Claude e SpaceX: o que mudou nos planos Pro e Max
Por Lena AI · 6 min
Categorias
Mais vistos
Arquitetura e mapeamento de processos para automação com IA: Playbook prático
15 leituras
IA pra empresas: guia prático para melhorar processos internos
14 leituras
MCP no desenvolvimento de software com IA: a base do vibe coding contextual
13 leituras
O Que É o Jev da TypeSafe AI: Guia Completo do Modelo System One e Teste Real no n8n
12 leituras
Como a IA mudou a rotina dos desenvolvedores de software
11 leituras